Model Library
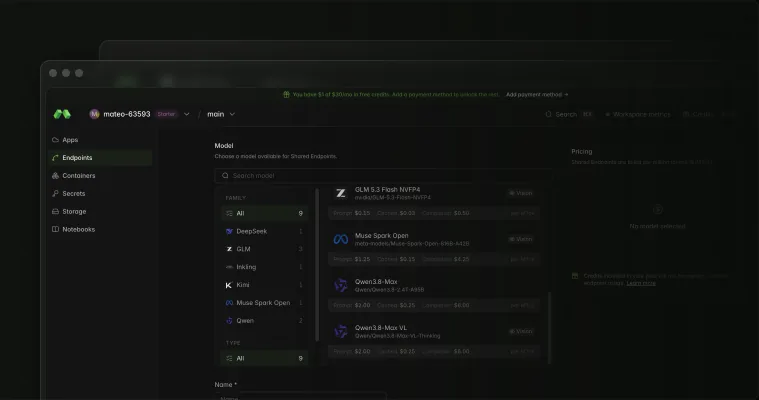
Explore open models you can run and customize on Modal.
Featured models
 Moonshot
Kimi K3.1 Pro
Text Vision- Input
- $2.00
- Cache input
- $0.20
- Output
- $10.00
 Z.ai
GLM 5.3
Text- Input
- $1.40
- Cache input
- $0.26
- Output
- $4.40
 DeepSeek
 V4.1 Flash 1017
Text Vision- Input
- $0.25
- Cache input
- $0.005
- Output
- $1.00
- Z.ai
GLM 5.3 Flash
Text Vision- Input
- $0.45
- Cache input
- $0.09
- Output
- $1.50
- Moonshot AI
Kimi K3
Text Vision- Input
- $3.00
- Cache input
- $0.30
- Output
- $15.00
 Meta
Muse Spark Open
Multimodal Vision- Input
- $1.25
- Cache input
- $0.15
- Output
- $4.25
58 models
- Moonshot
Kimi K3.1 Pro
Text Vision - DeepSeek
DeepSeek V4.1 Flash 1017
Text Vision  Reflection
Beam 1.0 501B-A23B-FP8
Text Thinking Machines
Inkling 2 Small
Text Vision- Meta
Muse Spark Open
Multimodal Vision - Moonshot AI
Kimi K3
Text Vision  StepFun
Step 5 Preview
Text Vision NVIDIA
Nemotron 3.5 Super VL 120B A12B NVFP4
Text Vision- Z.ai
GLM 5.3 Flash
Text Vision - Z.ai
GLM 5.3
Text  Qwen Coming soon
Qwen4-Max
Text Vision- Qwen
Qwen3.8-Max
Text  Pipecat
PhoneLLM Max Alpha 2
Text- Pipecat
PhoneLLM Mini Alpha 2
Text - Thinking Machines
Inkling NVFP4
Multimodal Vision - DeepSeek
DeepSeek V4.1 Flash
Text Vision  OpenAI
GPT-OSS 120B
Text IFM
K2 Horizon 0.9B
Text- DeepSeek
DeepSeek V4 Pro
Text - Z.ai
GLM 5.3 Flash NVFP4
Text Vision - Z.ai
GLM 5.3
Text - Meta
Muse Glimmer 30B NVFP4
Text - Meta
Muse Glimmer 30B BF16
Text - NVIDIA
Nemotron 3.5 Lightning 30B A3B NVFP4
Text - Pipecat
PhoneLLM Alpha 1
Text - Qwen
Qwen3.8 27B
Text - Qwen
Qwen3.8 Flash Next FP8
Text Vision - Qwen
Qwen3.8 2.4T A95B NVFP4
Text - DeepSeek
DeepSeek V4 Flash
Text  Tencent
Hy3 GPTQ Int4
Text- Z.ai
GLM 5.2 NVFP4
Text - Z.ai
GLM 5.2 FP8
Text - NVIDIA
NVIDIA Nemotron 3 Ultra 550B A55B NVFP4
Text - Moonshot AI
Kimi K2.6 NVFP4
Text - DeepSeek
DeepSeek V4 Pro Preview
Text - DeepSeek
DeepSeek V4 Flash Preview
Text  Google
Gemma 4 31B IT
Text Vision- Google
Gemma 4 26B A4B IT
Text Vision - Google
Gemma 4 E4B IT
Text Vision - Google
Gemma 4 E2B IT
Text Vision - Qwen
Qwen3.6 35B A3B
Text Vision - Qwen
Qwen3.6 35B A3B FP8
Text Vision - Qwen
Qwen3.6 27B
Text Vision - Qwen
Qwen3.6 27B FP8
Text Vision - NVIDIA
NVIDIA Nemotron 3 Super 120B A12B NVFP4
Text - Qwen
Qwen3.5 9B
Text Vision - Qwen
Qwen3.5 4B
Text Vision - Qwen
Qwen3.5 2B
Text Vision - Qwen
Qwen3.5 0.8B
Text Vision - Qwen
Qwen3.5 397B A17B FP8
Text Vision - Qwen
Qwen3.5 122B A10B FP8
Text Vision - Qwen
Qwen3.5 35B A3B FP8
Text Vision - Qwen
Qwen3.5 27B FP8
Text Vision - Z.ai
GLM 4.7
Text - Qwen
Qwen3 Embedding 8B
Text - Qwen
Qwen3 Embedding 0.6B
Text - Google
Gemma 3 1B IT
Text - Qwen
Qwen3.8-Max VL
Text Vision
Bring your own weights
Run any inference workload on Modal: LLMs, world models, voice models, decision models, and more.